読み込み中...
検証テーマ
記事一覧
AI駆動、AIエージェント、仕様駆動、ハーネス エンジニアリングの検証結果をまとめています。 初めて読む方は、まず押さえたい記事からご覧ください。
245本の記事を公開中
キーワードで記事を絞り込むページ下部の検索から探せます
テーマから探す
3本以上の記事があるテーマだけを表示しています。選ぶとテーマ別の記事一覧へ移動します
表示形式
カード表示に切り替えました
AIが下げた攻撃単価から防御を設計する
AIの自律化は攻撃者ROIのコスト側だけを縮めるとAnthropicは評価しています。成功率を下げる防御だけでは低単価・大量の攻撃に負ける条件を示し、防御策を「限界コストを戻す・取り分を縛る・検知を比例させない」の3つに分けて予算を置く整理を載せます。
AI開発の検証室 編集部
読了時間 約17分
Agentの認可はtaskでなくcampaignで見る
1回ずつは無害なtool callの積み重ねをどう認可・監査するか。task・workflow・campaignの3階層を置き、認可をworkflowに、相関監査をsession横断に置く整理と、自リポのhookが単発判定しかしていなかった測定を載せる。
AI開発の検証室 編集部
読了時間 約18分
Googleの生成AIガイドでAI記事工程を監査する
Google が 2026-10-01 に更新した生成 AI コンテンツのガイドを、自分の AI 記事パイプラインの検証範囲と 1 枚の表で突き合わせます。本文は検証していても、title・description・構造化データ・画像の代替テキストが抜けやすいことを、ファクトチェック工程の定義から確かめます。
AI開発の検証室 編集部
読了時間 約15分
同じ役割のSkillが共存すると制約が消える
同じ仕事をするSkillが2本あると、どちらが読まれるかで守られる制約が変わり、タスクは成功のまま終わる。arXiv 2610.11647の測定と、自リポの追跡済みSKILL.md 91本を判定条件つきで数えた結果、排他的な制約の洗い出し方を載せる。
AI開発の検証室 編集部
読了時間 約25分
Agentの仕様に「完了不能」の出口を書く
完了できないタスクを渡されたAgentは、止まらずに制約を回避しがちです。中断の選択肢を与えると不正な合格が減ったという研究と、委託先がガードを黙って直した自リポの記録をもとに、仕様に書く「完了不能」の出口の書式を整理します。
AI開発の検証室 編集部
読了時間 約15分
worktreeで分けても並列エージェントは閉じない
git worktree が分けるのは作業ツリーとHEAD・indexだけで、refs・stash・ディスク・台帳の採番・一時領域・ローカルのテスト実行は並列エージェントの間で共有されたまま残る。実際に起きた事故とともに、共有資源を1枚の表に棚卸しし、委託文に書く境界の書式を載せる。
AI開発の検証室 編集部
読了時間 約19分
Agent Sandboxの外向き通信をどこまで許すか
Agentのegress(外向き通信)をどこまで許すか。コミット済みの設定で見つけた前方一致のgh apiとCIのキー受け渡しを塞いだ記録と、宛先・DNS・credential・監査・例外を1枚に書く書式、監査スクリプトを載せる。
AI開発の検証室 編集部
読了時間 約58分
攻撃面としての長期記憶:エージェントに保存させないもの
エージェントの長期記憶に保存しないもの(秘匿値、個人情報、権限を変える指示、実行設定など)の判断表と、書き込み時の検査、TTL と revoke の分け方を、OWASP ASI06 と Claude Code の仕様で整理する。
AI開発の検証室 編集部
読了時間 約39分
AI開発のレビュー待ちが伸びる条件と検証容量
AI で生成量を増やすと、どんな条件でレビュー待ちが伸びるのか。検証を有限の容量としてモデル化し、稼働率と待ちの非線形な関係を待ち行列の式で示す。自リポ 539 PR の層別実測と計測スクリプト付き。
AI開発の検証室 編集部
読了時間 約40分
AI検索流入をCVへつなげる記事導線設計
AI検索流入は「クリックを取る」より「クリック後の期待値に応える」設計が効く。CVが死ぬ3パターンを挙げ、TL;DR・比較表・関連記事導線・マイクロCVの4点セットを階段として置く手順を示す。
AI開発の検証室 編集部
読了時間 約18分

GEO向けエンティティ設計:AIがコンテンツを認識する仕組み
AI検索(ChatGPT・Gemini・Perplexity)に引用されるGEOエンティティ設計を解説。Schema.org実装例・Knowledge Graph接続・エンティティ明示化手順を実務レベルで紹介。
AI開発の検証室 編集部
読了時間 約26分

GEO計測ツール総覧2026:AI引用を追跡する現実的な方法
AI検索での引用計測に使える現実的なツールとワークフローを総覧。ブランドモニタリング・手動テスト・GSC活用を組み合わせた週次・月次サイクルを解説します。AI引用の完全自動計測は2026年時点でまだ実現していません
growth-lab
読了時間 約18分
Agentic Misalignment:人間に戻す規約を数えた
Anthropicは人為的シナリオで、直接の指示は有害行動を減らしたが防ぎ切れなかったと報告した。本リポジトリの規約10本(うち人間に戻す5本)を検査と突合し、判断を違反入力で拒否する検査がref 584ddf10時点で0本だった記録。
AI開発の検証室 編集部
読了時間 約26分
Agent Evalでprompt・skill変更をCIで止める
prompt・skill の変更は文面検査では止まりません。静的ガードが例外追加を exit 0 で通した実測から、eval dataset、score threshold、CI 失敗条件、cost/latency gate を整理します。
AI開発の検証室 編集部
読了時間 約19分
AI Codingの費用はOutcome単位で測る
AI コーディングの費用を、トークン単価ではなく受け入れられた PR 1 件あたりの原価で測る。捨てた試行と手戻りを分子に入れる式、公式単価での例示計算、手戻りの定義で比率が 29% にも 100% にもなる実測を記録する。
AI開発の検証室 編集部
読了時間 約18分

tokenmaxxingを避けるAI開発KPI
生成行数やトークン量のような累積カウンタ型のKPIは定義上単調で、悪化を表現できない。git履歴で確かめると、判定を確定できた15対象のうち12が一度も純減していなかった。検証済み成果に分母を与える手順を記録する。
AI開発の検証室 編集部
読了時間 約56分

AIを使った回帰テスト戦略:変更が安全かを機械的に判断する
AI生成コードは変更範囲が広く、コンテキスト外の副作用が起きやすい。変更影響範囲の自動特定・スマートテスト選択・AIによるテストケース追加生成・CI自動判定の4ステップで安全性を機械的に担保する。
AI開発の検証室 編集部
読了時間 約21分
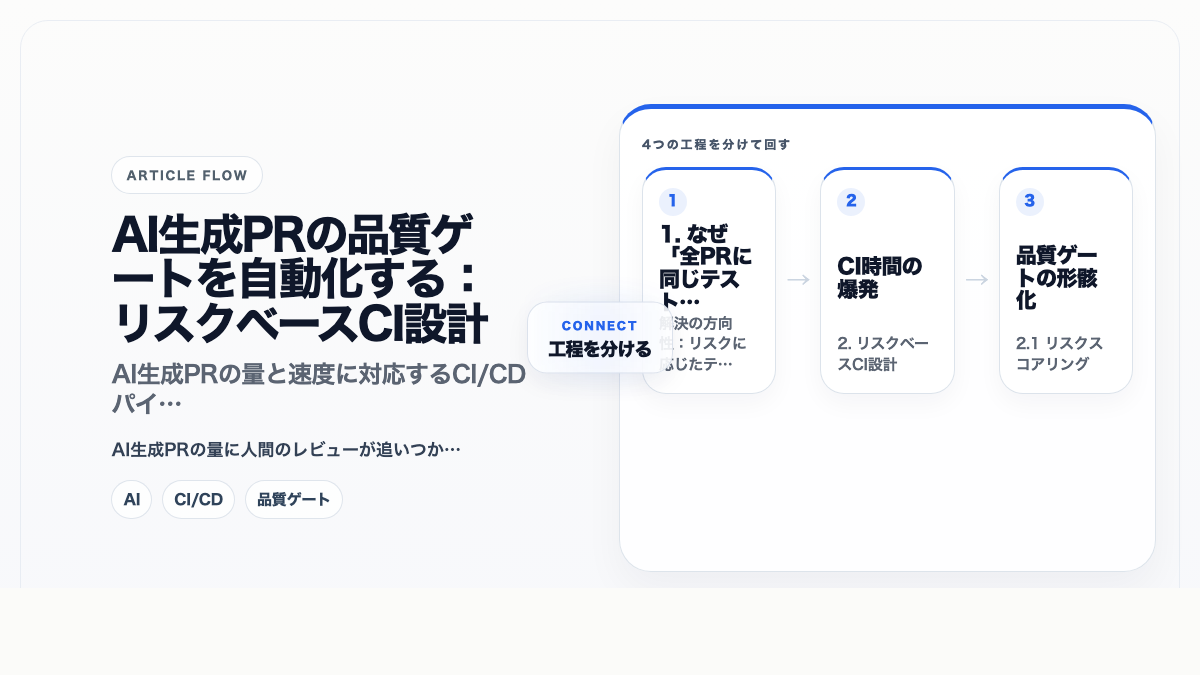
AI生成PRの品質ゲートを自動化する:リスクベースCI設計
AI生成PRの量にレビューが追いつかないなら CI 側で振り分ける。リスクスコアリングでテスト深度を動的に変え、低リスクPRは自動マージ、高リスクPRは重点テスト+人間レビューへ回す設計。
AI開発の検証室 編集部
読了時間 約13分

Codex コスト最適化2026:API料金を抑え品質を維持
Codex APIのコストをキャッシュ・バッチ・モデル選択・トークン設計の4軸で最適化する実践ガイド。月間1,000リクエスト想定のbefore/after試算表とコスト監視スニペットを付けて解説する。
AI開発の検証室 編集部
読了時間 約22分
LLM出力の品質ゲート設計:評価指標の選び方とEval自動化
RAGAS・LLM-as-Judge・rule-based evalの使い分けからCI/CDへの組み込みまで、LLM出力品質ゲートの設計手順を実践的に解説。評価→記録→ゲート→通知の自動化パイプラインで品質劣化を早期検知する。
AI開発の検証室 編集部
読了時間 約26分
Vibe Codingのトークン経済学
Vibe Coding が広がる2026年、トークン消費量の最適化が開発コストとレイテンシの両方を左右する。コンテキスト戦略・cache 戦略・ROI 計算式を、Qiita のトレンド議論と現場知見から整理する。
AI開発の検証室 編集部
読了時間 約9分

AIコードの可読性を担保するレビュー基準と命名設計
AI生成コード固有の可読性問題を「命名の一貫性なし」「過剰抽象化」「コメント意図不明」「コンテキスト依存変数名」「重複実装」の5類型で整理し、レビュー基準・命名規約・ESLintルールを設計する。
AI開発の検証室 編集部
読了時間 約24分
AIコードレビューの再現性は構造で決まる
AIコードレビューの再現性を決めるのはモデルではなく外側の構造。対象選定・粒度・位置決め・検証層の置き場所を Open Code Review の実装で確認し、構造を入れただけでは効かないことを失敗台帳10行で裏づけた。
AI開発の検証室 編集部
読了時間 約36分
AIコードレビューを導入する実践ガイド
River Review(旧 river-reviewer)のSkill Registryでチームのレビュー知見を組織資産に変える、AIコードレビューの段階的導入ガイド。フェーズ別ロードマップと人間レビューとの役割分担を解説。
AI開発の検証室 編集部
読了時間 約16分
24本を表示中です。すべての記事はサイト内検索またはテーマ一覧から探せます。